
@yossiz כתב בקוד C# לחילוץ טקסט מקבצי וורד:
עוד הערה קטנה: אני מבין שבצורך שלך זה לא כל כך רלוונטי, אבל לצרכים אחרים היה כדאי לקבל את מספרי ההערות
הוספתי כעת
פיסקאות ממוספרות הצלחתי לסמן רק עם * ולא עם המספרים
 P
הפורום כעת לקריאה בלבד, לקריאה נוספת.
@yossiz כתב בקוד C# לחילוץ טקסט מקבצי וורד:
עוד הערה קטנה: אני מבין שבצורך שלך זה לא כל כך רלוונטי, אבל לצרכים אחרים היה כדאי לקבל את מספרי ההערות
הוספתי כעת
פיסקאות ממוספרות הצלחתי לסמן רק עם * ולא עם המספרים
@yossiz
תנסה לבדוק עם keylogger האם המחשב קלט בכלל את המקשים או שיש בעיה יותר טכנית אולי
@yossiz כתב בקוד C# לחילוץ טקסט מקבצי וורד:
עוד הערה קטנה: אני מבין שבצורך שלך זה לא כל כך רלוונטי, אבל לצרכים אחרים היה כדאי לקבל את מספרי ההערות
אבדוק את זה תודה.
תכלס לבינתיים
בשיטה השניה מקבלים הכל כולל פיסקאות ממוספרות
מי שדחוף לו כל זה יכול להשתמש רק בשיטה השניה
החסרונות בשיטה השניה הם:
א. איטיות
ב. צריך שיהיה וורד מותקן במחשב (תאמינו או לא אבל יש אנשים שאין להם וורד במחשב)
@yossiz
בעיקר במקרה שהמסמך כבר פתוח ב-office
תכלס שיניתי כעת את הקוד שיעבור לשיטה השניה על כל שגיאה כדי שיכלול את מה ש-DOvid כתב להלן
using DocumentFormat.OpenXml.Packaging;
using System;
using System.IO;
using System.Runtime.InteropServices;
using System.Text;
using System.Xml;
using WordInterop = Microsoft.Office.Interop.Word;

namespace MsWordTextExtractor
{
    public static class DocxTextExtractor
    {
        public static string Extract(string filePath)
        {
            try
            {
                return ReadAllTextParts(filePath);
            }
            catch
            {
                return WordInteropExtractor(filePath);
            }
        }

        static string ReadAllTextParts(string filePath)
        {
            StringBuilder stb = new StringBuilder();
            using (WordprocessingDocument wordprocessingDocument = WordprocessingDocument.Open(filePath, false))
            {
                var mainPart = wordprocessingDocument.MainDocumentPart;
                stb.AppendLine(ReadTextPart(mainPart.GetStream()));

                if (mainPart.FootnotesPart != null)
                {
                    string footNotes = ReadFootnotesPart(mainPart.FootnotesPart.GetStream());
                    if (!string.IsNullOrEmpty(footNotes))
                    {
                        stb.AppendLine();
                        stb.AppendLine(footNotes);
                    }
                }

                if (mainPart.EndnotesPart != null)
                {
                    string footNotes = ReadFootnotesPart(mainPart.FootnotesPart.GetStream());
                    if (!string.IsNullOrEmpty(footNotes))
                    {
                        stb.AppendLine();
                        stb.AppendLine(footNotes);
                    }
                }
            }
            return stb.ToString();
        }

        static string ReadTextPart(Stream partStream)
        {
            NameTable nameTable = new NameTable();
            XmlNamespaceManager xmlNamespaceManager = new XmlNamespaceManager(nameTable);
            xmlNamespaceManager.AddNamespace("w", "http://schemas.openxmlformats.org/wordprocessingml/2006/main");
            StringBuilder stringBuilder = new StringBuilder();

            XmlDocument xmlDocument = new XmlDocument(nameTable);
            xmlDocument.Load(partStream);

            XmlNodeList paragraphNodes = xmlDocument.SelectNodes("//w:p", xmlNamespaceManager);
            foreach (XmlNode paragraphNode in paragraphNodes)
            {
                ReadTextContent(stringBuilder, paragraphNode, xmlNamespaceManager);
                stringBuilder.Append(Environment.NewLine);
            }
            return stringBuilder.ToString().Trim();
        }

        static string ReadFootnotesPart(Stream partStream)
        {
            NameTable nameTable = new NameTable();
            XmlNamespaceManager xmlNamespaceManager = new XmlNamespaceManager(nameTable);
            xmlNamespaceManager.AddNamespace("w", "http://schemas.openxmlformats.org/wordprocessingml/2006/main");
            StringBuilder stringBuilder = new StringBuilder();

            XmlDocument xmlDocument = new XmlDocument(nameTable);
            xmlDocument.Load(partStream);

            XmlNodeList footnoteNodes = xmlDocument.SelectNodes("//w:footnote | .//w:endnote", xmlNamespaceManager);
            foreach (XmlNode footnoteNode in footnoteNodes)
            {
                string footnoteId = footnoteNode.Attributes["w:id"].Value;
                if (footnoteId == "-1" || footnoteId == "0") { continue; }
                stringBuilder.Append($"{footnoteId}");

                ReadTextContent(stringBuilder, footnoteNode, xmlNamespaceManager);

                stringBuilder.AppendLine();
            }
            return stringBuilder.ToString().Trim();
        }

        static void ReadTextContent(StringBuilder stringBuilder, XmlNode xmlNode, XmlNamespaceManager xmlNamespaceManager)
        {
            XmlNodeList textNodes = xmlNode.SelectNodes(".//w:t | .//w:tab | .//w:br | .//w:footnoteReference | .//w:numPr", xmlNamespaceManager);
            foreach (XmlNode textNode in textNodes)
            {
                switch (textNode.Name)
                {
                    case "w:t":
                        stringBuilder.Append(textNode.InnerText);
                        break;

                    case "w:tab":
                        stringBuilder.Append("\t");
                        break;

                    case "w:br":
                        stringBuilder.Append("\v");
                        break;

                    case "w:footnoteReference":
                        string footnoteId = textNode.Attributes["w:id"].Value;
                        stringBuilder.Append($"{footnoteId}");
                        break;

                    case "w:numPr":
                        XmlNode ilvlNode = textNode.SelectSingleNode(".//w:ilvl", xmlNamespaceManager);
                        XmlNode numIdNode = textNode.SelectSingleNode(".//w:numId", xmlNamespaceManager);
                        if (ilvlNode != null && numIdNode != null)
                        {
                            stringBuilder.Append("*");
                        }
                        break;
                }
            }
        }

        public static string WordInteropExtractor(string filePath)
        {
            string tempFilePath = Path.Combine(Path.GetTempPath(), Path.GetFileNameWithoutExtension(filePath) + ".txt");


            try
            {
                using (WordApp wordApp = new WordApp())
                {
                    WordInterop.Document doc = null;
                    bool isFileAlreadyOpen = false;

                    foreach (WordInterop.Document openDoc in wordApp.App.Documents)
                    {
                        if (openDoc.FullName.Equals(Path.GetFullPath(filePath), StringComparison.OrdinalIgnoreCase))
                        {
                            doc = openDoc;
                            isFileAlreadyOpen = true;
                            break;
                        }
                    }

                    if (doc == null) doc = wordApp.App.Documents.Open(filePath, ReadOnly: true, Visible: false);

                    var originalFormat = doc.SaveFormat;
                    doc.SaveAs2(tempFilePath, WordInterop.WdSaveFormat.wdFormatUnicodeText, Encoding: 65001, AddToRecentFiles: false);
                    if (isFileAlreadyOpen) doc.SaveAs2(filePath, originalFormat);

                    if (doc != null && !isFileAlreadyOpen) doc.Close(WordInterop.WdSaveOptions.wdDoNotSaveChanges);
                }

                return File.ReadAllText(tempFilePath);
            }
            catch (Exception ex)
            {
                Console.WriteLine(ex.Message);
                return string.Empty;
            }
            finally
            {
                if (File.Exists(tempFilePath)) File.Delete(tempFilePath);
            }
        }
    }

    class WordApp : IDisposable
    {
        public Microsoft.Office.Interop.Word.Application App;
        bool isNewApp;

        public WordApp()
        {
            try
            {
                App = (WordInterop.Application)Marshal.GetActiveObject("Word.Application");
            }
            catch (COMException)
            {
                App = new WordInterop.Application();
                isNewApp = true;
            }
        }

        public void Dispose()
        {
            if (isNewApp && App != null)
            {
                App.Quit();
                Marshal.ReleaseComObject(App);
            }
        }
    }
}
עריכה:
מי שרוצה לחלץ טקסט מקבצי doc ללא שימוש באופיס יכול להשתמש בספרייה NPOI.HWPF
עם הקוד דלהלן
internal class NpoiDocExtractor
{
    public static string ExtractTextFromDoc(string filePath)
    {
        using (FileStream fileStream = new FileStream(filePath, FileMode.Open, FileAccess.Read))
        {
            HWPFDocument doc = new HWPFDocument(fileStream);
            WordExtractor extractor = new WordExtractor(doc);
            return extractor.Text;
        }
    }
}
הספרייה עושה עבודה די טובה החסרון היחיד שלה הוא שהיא לא מחלצת את מספרי ההערות
הערה חשובה:
לאחר חקירת הנושא גיליתי שצריך לעבוד עם אחוזים ולא כמו שעשיתי
עיין כאן להסבר מפורט
https://brianlagunas.com/does-reporting-progress-with-task-run-freeze-your-wpf-ui/
עריכה:
בדיקות שעשיתי יוצא שבעל הכתבה איננו צודק לא היה שום שיפור באחוזים לעומת מה שאני עשיתי
מה שכן מצאתי ששימוש ב- אפשרות של -Background ב-Dispathcer מועיל קימעא
Application.Current.Dispatcher.BeginInvoke(new Action(() =>
{
   }), DispatcherPriority.Background);
@dovid
אם הבנתי נכון אזי בקוד שהצגת שמות העמודות הם סטטיים ("Name", Age") רק התוכן הוא דינאמי אני מחפש שגם שמות העמודות יהיו דינאמיים
אולי אציג את הצורך הספיציפי שלי אזי נוכל להגיע לתשובה יותר מהר אני מנסה לייצר פקד כזה (התמונה מאוצר החכמה)
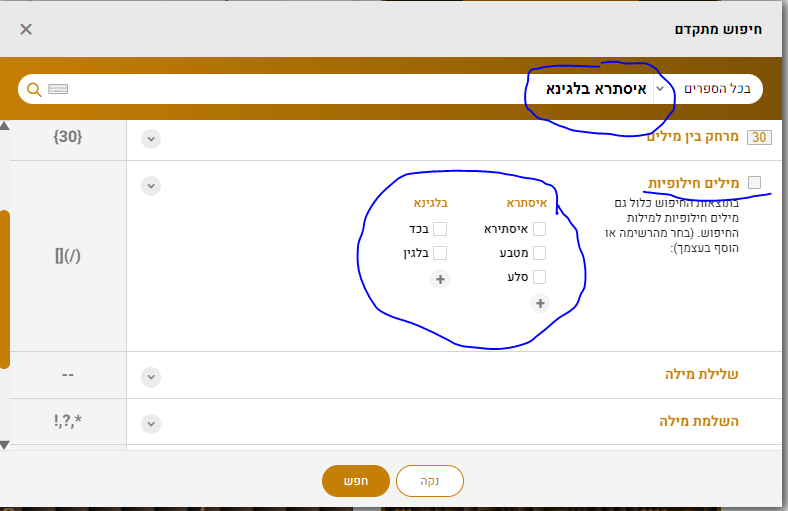
בעצם הפקד לוקח רשימה של מילים ויוצר עמודות של מילים חילופיות עבורם לבחירה על ידי המשתמש
אני מנסה לייצר DataGrid כולל ה- Headers באופן דינאמי
כל המדריכים שקראתי מתארים איך לייצר את התוכן באופן דינאמי אבל אני לא מצליח לייצר את הכותרות באופן דינאמי ואז למלאות את התאים אשמח לקבל הדרכה בנושא.
@אלף-שין
אני מעריך את הרצון שלך להעמיק ולחקור את התחום, אך ברצוני להציע לך לשקול לא להשקיע את זמנך בדברים הללו. חקירה שטחית של נושא מורכב כמו אינדוקס ללא הבנה מעמיקה יותר עלולה לגזול זמן רב ויקר ממך ולא להביא לתוצאות הרצויות.
בהצלחה בדרכך!
@yossiz כתב בבאיזה תוכנת אינדקס גוגל משתמשים?:
עיין כתבה זו על האתגרים המיוחדים בעברית
הכתבה הנ"ל לבסוף הובילה לפרוייקט יפה מאוד שקורים לו HEBMORPH.
ברצוני לכתוב כמה השגות שהיו לי על פרוייקט זה - בעצם כמנוע חיפוש כללי הוא באמת משדרג את החיפוש בהמון. חשוב לציין שהמילון שהוא משתמש בו נמצא בשימוש על ידי מנוע החיפוש של גוגל ועוד כמה מנועי חיפוש מפורסמים והעקרונות שלו ה עקרונות חזקים ומנוסים.
יחד עם זאת כשמדברים על HEBMORPH ודומיו, חשוב להבין שמדובר בפרויקט שמנסה לבנות חיפוש חכם בעברית. אבל האם חיפוש חכם מתאים תמיד לצרכי המשתמש? אני לא בטוח. ניקח לדוגמה את הסרת ה-stopwords (מילים כמו "כי"). בחיפוש כללי, זה מייעל את האינדוקס והחיפוש, אבל בחיפוש תורני, לעיתים עדיף לחפש את המשפט כולל "כי", במיוחד בחיפוש פסוקים. בנוסף, הפרויקט HEBMORPH מבוסס על מילון עברי כללי, מה שמפחית את ביצועיו בחיפוש תורני.
עריכה: כל זה נכון אם יש לך אמפמינציה אישית של lucene אבל אם אתה משתמש בו כמות שהוא אתה רק מרוויח אם אתה משתמש ב-HEBMORPH למה? כי Lecene הינו מנוע חיפוש ולשכך הוא בנוי על אלגוריתמים שמחשבים רלוונטיות וממילא כל כלי שמתעל את הרלוונטיות מתעל את המנוע.
הנקודה היא שקשה לייצר מנוע חיפוש כוללני כי הצרכים משתנים ממקרה למקרה.
אישית בתוכנות שלי ב-C# אני לא משתמש ב- HEBMORPH מחמת סיבה צדדית, כי הוא לא מעודכן לגרסה האחרונה של Lucene, מה שמקשה מאוד על השימוש בו. אציין גם שיש חלקים בקוד שהם ממש לא אינטואיטיביים, כך שהתייאשתי לבינתיים מלנסות להתאים את HEBMORPH לגרסה הנוכחית. זה יצריך ממני ללמוד לעומק את הגרסה הישנה ואז לתרגם אותה לחדשה, ואין לי את הזמן או את העצבים לזה.
@yossiz
הסיבה לסגור את התוכנה מה-debugger הוא במקרה שיש באג שתוקע את ה-UI
חוץ מהשאלה שלך שים לב שדלת הזזה מאוד קשה לאטום מבחינת מזג אויר
@אנא
אם המחשב מתחמם באופן קיצוני ללא הפוגה (לא נעים לגעת בו) אכן זה לא טוב למחשב
קשה לדעת באיזה ארון מדובר אבל מסתמא תוכל לייצר איזשהו פתח אוורור שכנראה מאוד נצרך עדיף כמה שיותר קרוה לפתח של המאוורר וכמובן לוודא שהפתח של המאוורר פתוח לאוויר ולא צמוד לגב הארון או משהו כזה
יש לי קוד שמופעל כאשר התוכנה נסגרת כדי לסגור משאבים שלא נסגרים אוטומטית (כמו חיבורי COM שגיליתי שנשארים פתוחים באמצעות בדיקה ב-Task Manager).
הבעיה היא שאם אני לוחץ על לחצן ה-Stop ב-Visual Studio במהלך ניפוי הבאגים (debugging), הקוד לסגירת המשאבים לא רץ, מה שגורם לשגיאות לא נעימות בתוכנה בכל פעם מחדש.
האם יש דרך לפתור את הבעיה הזו?
אמנם יש דברים כבר קיימים ויש גם כאלה שמשתמשים בAPI של ווינדוס אבל מטעמים שונים לא הייתי מרוצה מהם ולכן עשיתי את הקוד דלהלן:
הקוד מציג את ההתקדמות על יד progressbar
ועל ידי הצגת התקדמות מתוך ה-maximum כטקסט
הקוד מציג גם את ההתקדמות באייקון בשורת המשימות
הקוד מציג את ההתקדמות גם בפעולות async
הקוד הוא בגדר סקיצה ואשמח מאוד לקבל משוב:
using System;
using System.Windows.Controls;
using System.Windows;
using System.Windows.Data;
using System.Windows.Shell;

namespace FullText.Controls
{
    public static class ProgressDialog
    {
        public static IProgress<double> Start(string message, int maximum)
        {
            IProgress<double> reporter = null;
            Application.Current.Dispatcher.Invoke(() => {

                TextBlock textBlock = new TextBlock { Text = message, TextWrapping = TextWrapping.WrapWithOverflow, Margin = new Thickness(5), };
                ProgressBar progressBar = new ProgressBar { Maximum = maximum};
                TextBlock percentageTextBlock = new TextBlock { HorizontalAlignment = HorizontalAlignment.Center, VerticalAlignment = VerticalAlignment.Center , Margin = new Thickness(1) };
                Binding binding = new Binding("Value") { Source = progressBar, StringFormat = $"{{0:0}} \\ {maximum}" };
                percentageTextBlock.SetBinding(TextBlock.TextProperty, binding);
                Grid grid = new Grid { Margin = new Thickness(5) };
                grid.Children.Add(progressBar);
                grid.Children.Add(percentageTextBlock);
                StackPanel stackPanel = new StackPanel();
                stackPanel.Children.Add(grid);
                stackPanel.Children.Add(textBlock);
                Window window = new Window
                {
                    Content = stackPanel,
                    SizeToContent = SizeToContent.WidthAndHeight,
                    FlowDirection = FlowDirection.RightToLeft,
                    Owner = Application.Current.MainWindow,
                    ResizeMode = ResizeMode.CanMinimize
                };

                TaskbarItemInfo taskbarItemInfo = new TaskbarItemInfo();
                //Application.Current.MainWindow.TaskbarItemInfo = taskbarItemInfo;
                window.TaskbarItemInfo = taskbarItemInfo;
                taskbarItemInfo.ProgressState = TaskbarItemProgressState.Normal;

                reporter = new Progress<double>(OnProgressChanged);
                void OnProgressChanged(double incrementValue)
                {
                    if (incrementValue == -1) { taskbarItemInfo.ProgressState = TaskbarItemProgressState.None; window.Close(); }
                    //else if (progressBar.Value >= progressBar.Maximum) { window.Close(); taskbarItemInfo.ProgressState = TaskbarItemProgressState.None; }
                    else
                    {
                        progressBar.Value += incrementValue;
                        taskbarItemInfo.ProgressValue = (double)progressBar.Value / progressBar.Maximum;
                    }
                }

                window.Show();
            });

            return reporter;
        }
    }
}
צורת שימוש
התחלה
var progressReporter = ProgressReporter.Start($"מאנדקס את: {directoryToIndex}", files.Count);
התקדמות
progressReporter.Report(1);
סיום וסגירה
progressReporter.Report(-1);
@אלף-שין
כשזהו החיסרון היחיד זה מתגמד לעומת כל שאר התועליות
@sivan22 כתב בספריית החיפוש meilisearch ב-בC#:
בפרט טיפול מיוחד בעברית כולל הבנת שורשים מתקדמת עם מילון וגם אלגוריתמים, שזו עבודת נמלים לבנות לבד.
הספקת לבדוק ביצועים ב-meilisearch בנוגע לזה? מאוד מסקרן אותי כמה הם מוצלחים בזה בפרט בטקסטים של חז"ל.
<!DOCTYPE html>
<html lang="auto">
<head>
    <meta charset="UTF-8">
    <title>Search Highlight Page</title>
    <style>
        body {margin:0;}
        .highlight {
            background-color: yellow;
        }
        .selected-highlight {
            background-color: orange;
        }
    </style>
</head>
<body dir='rtl'>
    <div id="searchContainer" style="position: fixed; top: 0; margin:0; padding: 5px; width: 100%; background-color:whitesmoke;">
        <input type="text" id="searchBar" placeholder="הזן טקסט לחיפוש" style="border: none; padding:5px;" onkeydown="handleEnter(event)">
        <button id="searchButton" style="border: none; padding:5px;" onclick="searchNext()">חפש</button>
        <button id="previousButton" style="border: none; padding:5px;" onclick="searchPrevious()">הקודם</button>
        <label><input type="checkbox" id="regexCheckbox"> חיפוש בעזרת Regex</label>
    </div>

    <div id="content" style="padding-top: 25px; margin:5px;">
        <!-- Example content to search through -->
        <p>וידאו מספק דרך רבת-עוצמה שתעזור לך להוכיח את הנקודה שלך. בעת הלחיצה על 'וידאו מקוון', באפשרותך להדביק את הקוד המוטבע של הווידאו שברצונך להוסיף. ניתן גם להקליד מילת מפתח כדי לחפש באופן מקוון אחר וידאו שיתאים בצורה הטובה ביותר למסמך שלך.</p>
        <p>כדי להעניק למסמך שלך מראה מקצועי, Word מספק עיצובים של כותרת עליונה, כותרת תחתונה, עמוד שער ותיבת טקסט אשר משלימים זה את זה. לדוגמה, באפשרותך להוסיף עמוד שער, כותרת עליונה וסרגל צידי תואמים. לחץ על 'הוסף' ולאחר מכן בחר את הרכיבים הרצויים מהגלריות השונות.</p>
        <p>ערכות נושא וסגנונות גם שומרים על התיאום של המסמך שלך. בעת הלחיצה על 'עיצוב' ובחירת ערכת נושא חדשה, התמונות, התרשימים וגרפיקת SmartArt משתנים בהתאם לערכת הנושא החדשה שלך. בעת החלת סגנונות, הכותרות משתנות בהתאם לערכת הנושא החדשה.</p>
        <p>חסוך זמן בעבודה ב- Word בעזרת לחצנים חדשים המופיעים במקומות הנכונים. כדי לשנות את אופן ההתאמה של תמונה למסמך, לחץ עליה ולצידה יופיע לחצן של אפשרויות פריסה. בעת העבודה על טבלה כלשהי, לחץ במקום שבו ברצונך להוסיף שורה או עמודה, ולאחר מכן לחץ על סימן החיבור.</p>
        <p>כמו כן, קל יותר לקרוא בתצוגת הקריאה החדשה. באפשרותך לכווץ חלקים של המסמך ולהתמקד בטקסט הרצוי. אם עליך להפסיק לקרוא לפני שאתה מגיע לסוף המסמך, Word זוכר את המקום שאליו הגעת - אפילו בהתקן אחר.</p>
    </div>

    <script>
        let currentIndex = 0;
        let previousSearchTerm = "";
        let direction = 'next';

        function removeHighlights() {
            const highlights = document.querySelectorAll('.highlight, .selected-highlight');
            highlights.forEach(highlight => {
                const parent = highlight.parentNode;
                while (highlight.firstChild) {
                    parent.insertBefore(highlight.firstChild, highlight);
                }
                parent.removeChild(highlight);
            });
        }

        function highlightSearchTerm(searchTerm, useRegex) {
            const regex = useRegex ? new RegExp(`(${searchTerm})`, 'gi') : new RegExp(`(${searchTerm.replace(/[.*+?^${}()|[\]\\]/g, '\\$&')})`, 'gi');
            const content = document.getElementById('content');
            content.innerHTML = content.innerHTML.replace(regex, '<span class="highlight">$1</span>');
        }

        function searchAndHighlight() {
            const searchTerm = document.getElementById('searchBar').value;
            const useRegex = document.getElementById('regexCheckbox').checked;
            removeHighlights();
            if (searchTerm) {
                highlightSearchTerm(searchTerm, useRegex);
                const highlightedElements = document.querySelectorAll('.highlight');
                if (highlightedElements.length) {
                    if (searchTerm === previousSearchTerm && direction === 'next') {
                        currentIndex++;
                        if (currentIndex >= highlightedElements.length) {
                            currentIndex = 0;
                        }
                    } else if (searchTerm === previousSearchTerm && direction === 'previous') {
                        currentIndex--;
                        if (currentIndex < 0) {
                            currentIndex = highlightedElements.length - 1;
                        }
                    } else {
                        currentIndex = 0;
                    }

                    highlightedElements.forEach(element => element.classList.remove('selected-highlight'));
                    highlightedElements[currentIndex].classList.add('selected-highlight');
                    highlightedElements[currentIndex].scrollIntoView({ block: "center" });
                }
            } else {
                alert('Please enter a search term.');
            }
            previousSearchTerm = searchTerm;
        }

        function searchPrevious() {
            direction = 'previous';
            searchAndHighlight();
        }

        function searchNext() {
            direction = 'next';
            searchAndHighlight();
        }

        function handleEnter(event) {
            if (event.key === 'Enter') {
                event.preventDefault(); // Prevent default Enter key behavior (like form submission)
                searchNext();
            }
        }
    </script>
</body>
</html>
מישהו יכול להגיד לי אולי אם זה
https://stackoverflow.com/a/85273/23343154
רעיון טוב?
@ששא
זו תוכנה בתשלום סימלי
בעל התוכנה איננו מבלה את זמנו בפורום ולכן ביקש ממך שתפנה אליו בצורה מסודרת למייל.